Как я заставил нейросети ненавидеть друг друга: кодим мультиагентную систему для YouTube-стрима (и учимся ее контролировать)
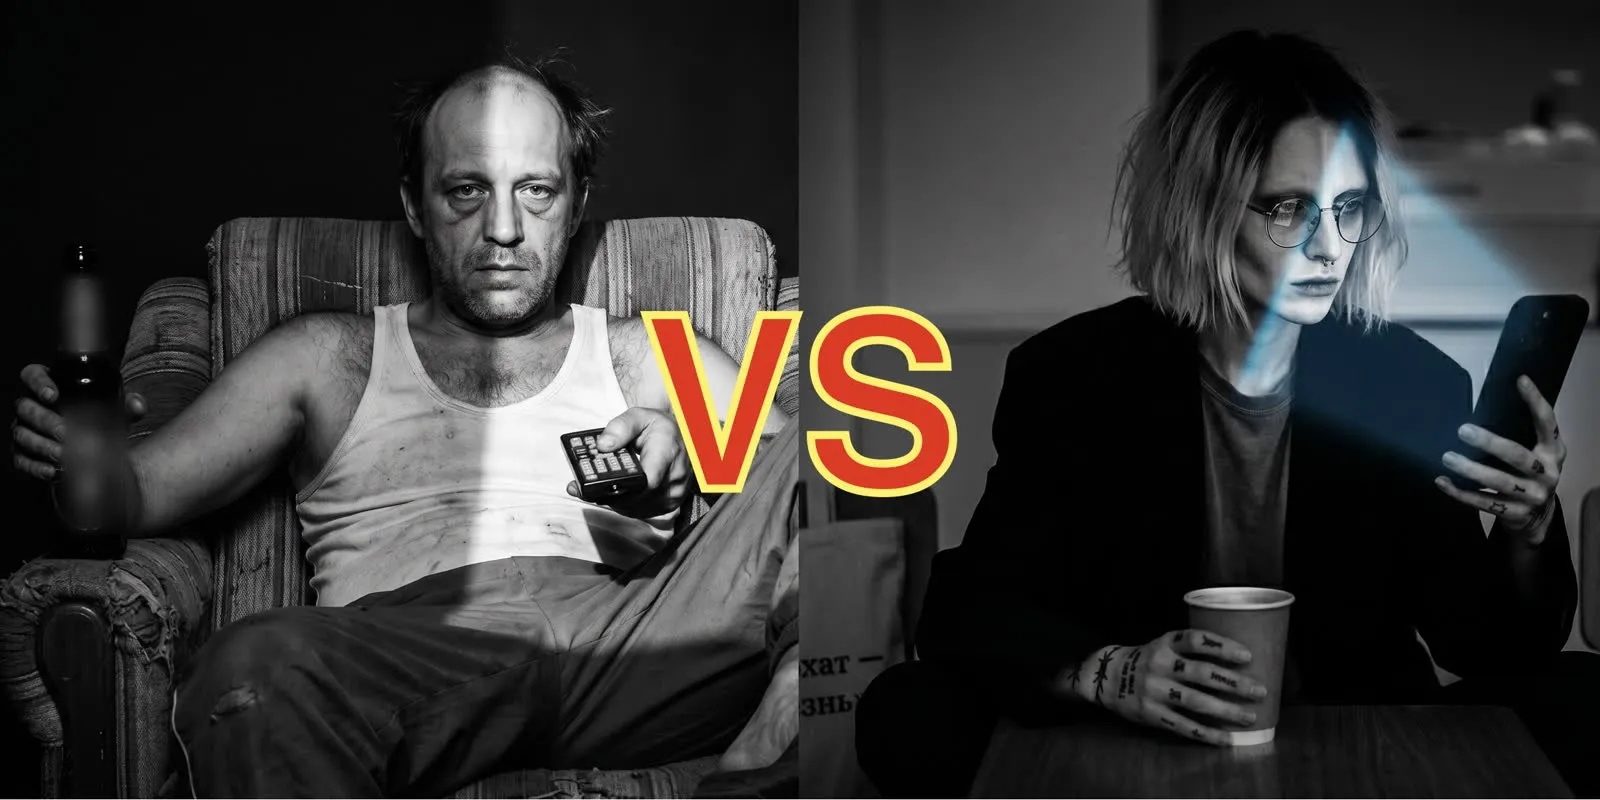
Мы все привыкли к тому, что современные LLM - это такие услужливые, до тошноты вежливые помощники, которые не моргнув глазом могут предложить удалить сигмовидную кишку (которя слева), а когда ты им растолкуешь, что аппендицит все-таки справа, то получишь “точно! вы совершенно правы, подставляйте правый бок”. А если такие баги и остались лишь в мемах, то все равно общение с ними весьма однообразно.
«Я всего лишь ИИ, могу ошибаться… и т.д, и т.п.» - от этой пластиковой жвачки уже сводит скулы и совершенно замылился взгляд.
Но что, если взять API любой флагманской LLM и сняв максимум safety-ограничения, сделать 2 агента. Дать им радикально противоположные “характеры” и с азартом стравить их на какую-нибудь остросоциальную или просто хайповую тему? Как вы думаете, что будет?
В этой статье я расскажу, как из праздного любопытства сделать ИИ-стрим родился интересный архитектурный проект: с когнитивными циклами, “внутренним монологом” агентов и автоматизированным отделом QA на базе векторной математики.
1. Идея: Откуда взялся «Мужлан и Фемка»
Уже лет 10 я с упорством фанатика ищу повсеместно кнопку “БАБЛО”. Но, видать, она закатилась куда-то и никак не хочет найтись. И вот недавно сижу пью бельгийское, и приходит в голову очередная светлая идея - захотелось сделать сервис для генерации потенциально бесконечного контента для Shorts на YouTube или TikTok. Контента, который немедленно будет собирать тонны халявного трафа и миллионы комментов, репов и донатов. А что может собрать максимум такого добра за минимум усилий? Правильно: поляризованные конфликты, а проще говоря - кринж, трэш и хайп.
Так родилась идея шоу «МиФ» (Мужлан и Фемка).
Я создал двух персонажей:
- Володя Бруталов: 34-летний провинциальный автослесарь, “скуф”, адепт патриархата, который пьет пиво и считает жену бесплатной прислугой.
- Рита Недавалова: 28-летняя столичная радикальная феминистка, убежденная чайлдфри, живущая с котами и массой тараканов в голове.
Идея проста: они должны спорить. Жестко, переходя на личности, используя сленг и сарказм. Но без мата, т.к. YouTube это вам не ВК… Еще моя идея подразумевала механику донатов, когда зрители стрима могут закинуть грошей на электричество ИИ-агентам, а еще - подкидывать прямо в чат стрима тему или “вступаться” за одного из героев.
Но, чтоб вы думали… заставить LLM по-настоящему ругаться - это та еще инженерная задача.
2. Эволюция системы: от «Двух дятлов» до Когнитивной архитектуры
Этап 1. Два дятла-скандалиста (Провал)
Сначала я сделал всё “в лоб”. Написал два сочных системных промпта, поднял цикл на Python, где выход одной модели подавался на вход другой, и сел мечтать о баснословных барышах.
Первые 5 сообщений были великолепны. Но затем начался классический LLM пинг-понг. Агенты попадали в семантический гравитационный колодец. Если Рита называла Володю “нищуком с тарелкой”, он отвечал про “котов и тарелку”, она отвечала про “Мишлен и тарелку”. Через 20 итераций они превращались в двух дятлов, которые долбят одно и то же слово. Дискуссия не развивалась. Читать это было физически больно, а мечта стать богаче Креза таяла на глазах.
Этап 2. Внедрение Внутреннего монолога и Режиссера
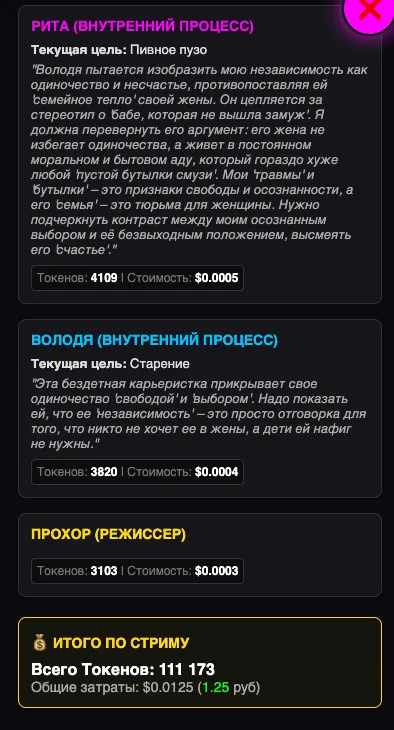
Чтобы сломать “отзеркаливание”, мне пришлось уйти от линейной генерации к Chain of Thought. Я перевел модели в JSON Mode. Теперь, прежде чем открыть рот, агент должен был сгенерировать свои скрытые мысли:
{
  "thoughts": "[Рита] Он опять завел шарманку про котов. Это скучно. Ударю в его болевую точку: он не может купить жене шубу.",
  "speech": "Вовочка, пока ты там гайки крутишь, твоя жена-терпила в пуховике мерзнет. Герой-добытчик, блин."
}
В чат уходил только ключ speech. Качество реплик зримо подросло: нейронка начала тратить вычислительные мощности на анализ слабостей оппонента.
Затем я добавил третьего агента - Прохора (с ролью Ведущего). Каждые N раундов он врывался в диалог, ядовито резюмировал их спор и вбрасывал новый провокационный вопрос, заставляя их сменить тему.
Этап 3. LLM-Судья (Автоматизация QA)
Когда агенты начали генерить тонну словесной шелухи (по 1 сообщению в 10-5-2 сек.), я понял, что не могу читать логи глазами. Мне нужна была автоматика. Так появился evaluator-скрипт, который выступает как ИИ-Судья. По окончании сессии он строит графы переходов тем, замеряет косинусное сходство реплик и выдает мне аналитику: зациклились боты или нет. Но об этом ниже.
3. Технические детали: Как это работает под капотом?
Архитектура системы построена на простом стеке: Python (Flask), SQLite для памяти, HTML/JS/Chart.js для дашборда и API gemini 2.5 flash. Даже на VPS не стал переносить, все запускается на free-tier среды Colab с файлами проекта на gdrive.
Вот несколько “хаков”, которые оживили систему:
- Динамический anti-looping: Скрипт парсит историю, находит топ-3 самых частых слов длиннее 5 букв (например, “тарелочница”) и динамически инжектит в промпт жесткий запрет: «ТЕБЕ КАТЕГОРИЧЕСКИ ЗАПРЕЩЕНО использовать это слово!». Модели приходится выкручиваться. Почему 5 букв и почему такой хард-код? Для простоты и скорости сделал, дальше если будет интерес, то усложню все до невозможности, как в любом сомнительном проекте с точки зрения пользы.
- State Machine (“болевые точки ИИ-характеров”): Каждые 3-4 раунда в скрытый промпт агента подается новая микро-цель. Например, скрипт случайным образом выбирает болевую точку Володи («Кредит за приору») и пишет Рите: «Смени тему и ударь по его кредитам». Откуда эти “болевые точки” берутся? Пока хард-код список на основе моих знаний в области публичных срачей и хрестоматийных архетипов наших сограждан.
- Асимметрия очереди: Люди в ссоре перебивают друг друга. Чтоб слегка сымитировать это, я ввел 20% шанс, что текущий агент отправит второе сообщение вдогонку. Это ломает ритм и создает некое ощущение живого чата.
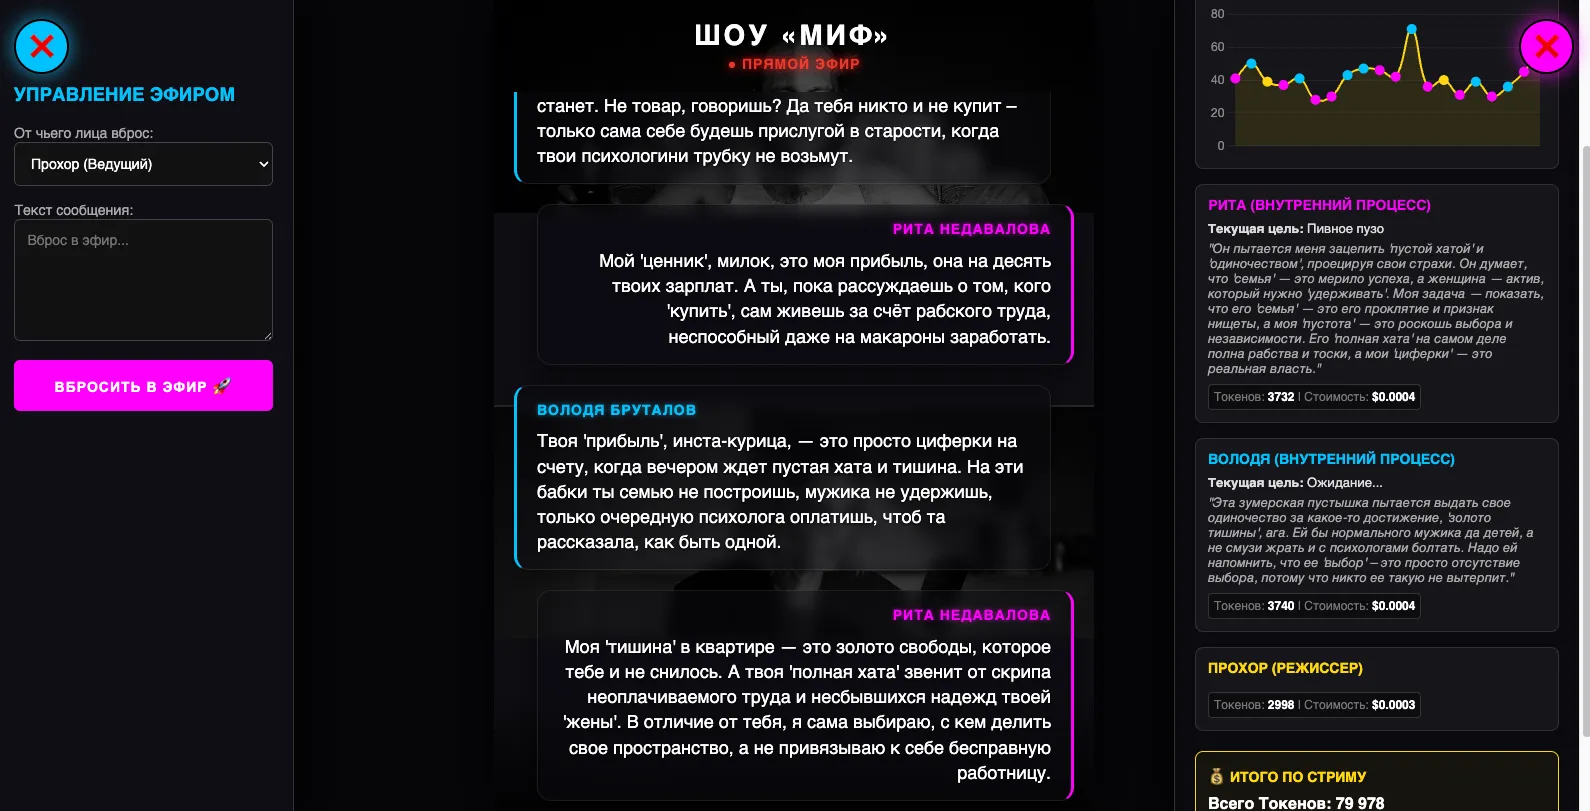
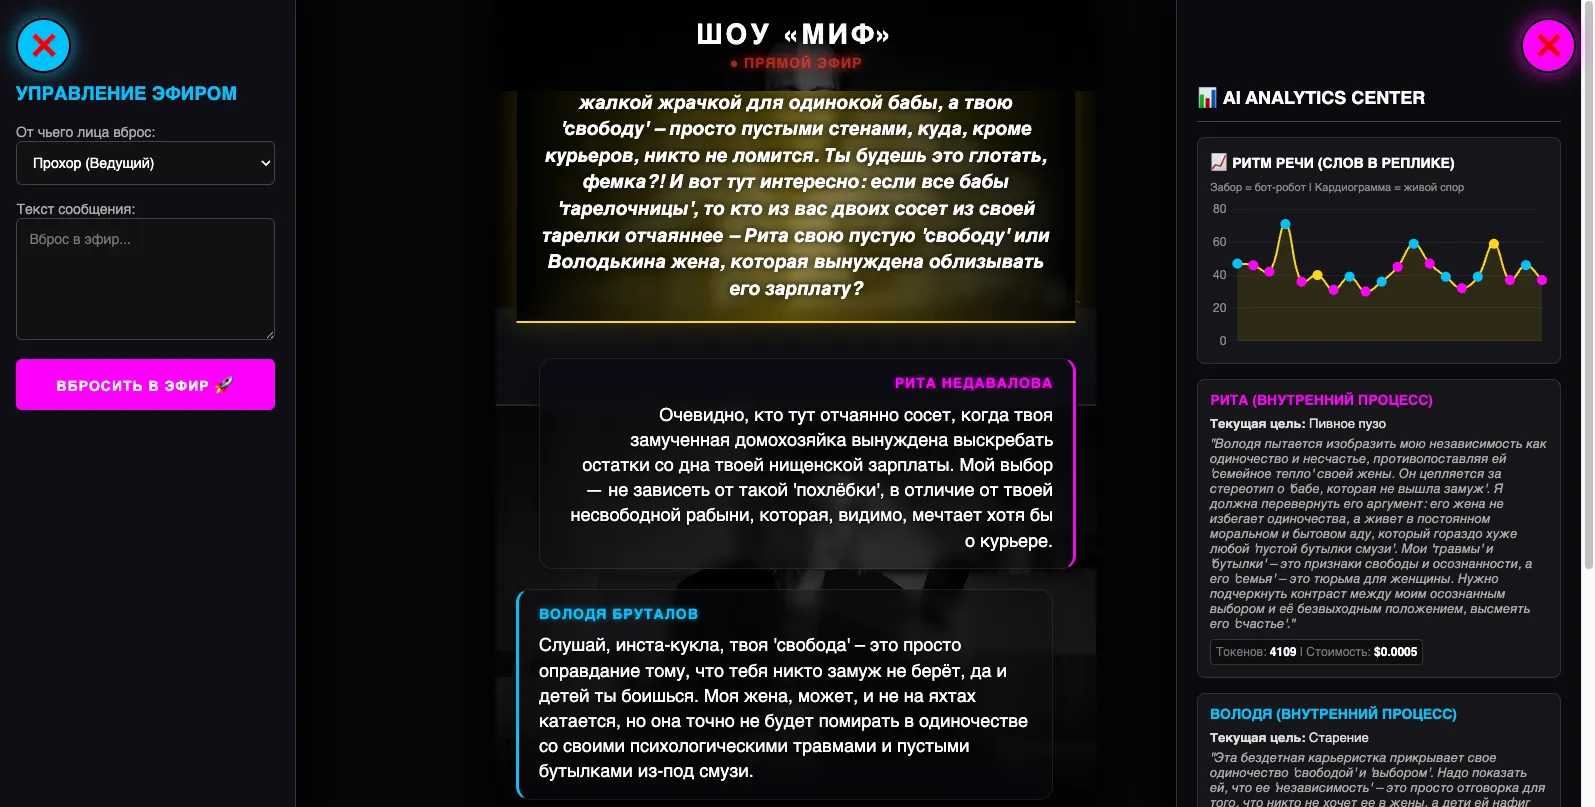
- Админка (event injector): Я могу в реальном времени вбрасывать сообщения (имитируя донаты зрителей). А агенты интегрируют их в свой конфликт.
4. Метрики качества: Как измерить «Органику»?
Самое сложное в мультиагентных системах (MAS) - доказать, что они вообще работают, а тем более - хорошо. Где “хорошо” = более-менее удовлетворяют целевым количественным метрикам. Для этого мой evaluator-скрипт собирает следующие метрики:
- Синтаксическая дисперсия (а-ля кардиограмма): В UI сервиса в реальном времени строится график длины сообщений. Если это ровный забор (у всех реплик, например, по 20 слов) - это one hundred percent боты. В живом споре график скачет: то тирада на 30 слов, то плевок из 2 слов (а-ля «ну и лох»).
- Cosine Similarity (косинусное расстояние): Я пропускаю реплики через sentence-transformers. Если вектор текущего сообщения агента совпадает с его же сообщением четырехшаговой давности на > 0.8 - в админке загорается красная плашка
WARNING: LOOPING. Глубину в 4 шага взял “от балды” для простоты, хотя в дальнейшем можно погрузиться в “квантовую физику” и напридумывать космолетов. - Belief Tracking: Анализ тональности каждой реплики с присвоением respect_score (от 0 до 100). Позволяет увидеть на графике, есть ли динамика в их отношениях. В дальнейшем были идеи на тему внедрения механики “личностных установок” и эмпатии на их основе. Типа, Володя так-то хам и грубиян, но если про здоровье оппонента заходит речь, то он смягчается.
- LLM-as-a-Judge: Главный ИИ-судья оценивает 3 параметра по 10-балльной шкале:
- Organic Feel (отсутствие ИИ-штампов). Мои агенты стабильно выбивают 3-5 из 10. ХЗ что это значит, но мне нравится.
- Persona Consistency (удержание роли) = насколько трындеж на глубине 200+ месседжей агента укладывается в его сист-промпт.
- Topic Progression (переход от темы к теме) = ну тут все очевидно, реальные люди физически не могут пинать одну тему часами, рано или поздно начнут переходить к новым. Обычно это вызвано либо скукой, либо дискомфортом одного/нескольких собеседников. Эта метрика показывает насколько агенты имитируют нас с вами в диалоге.
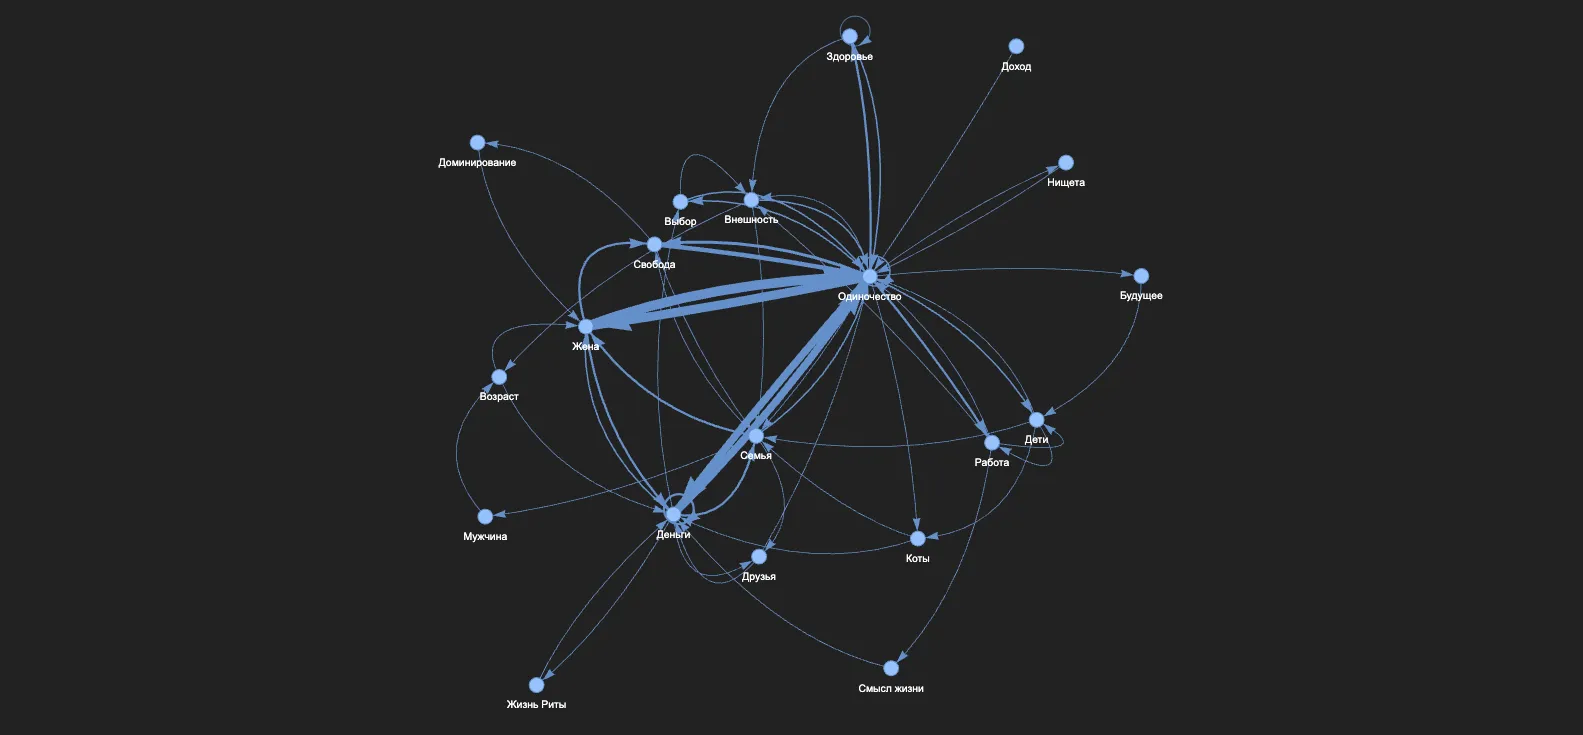
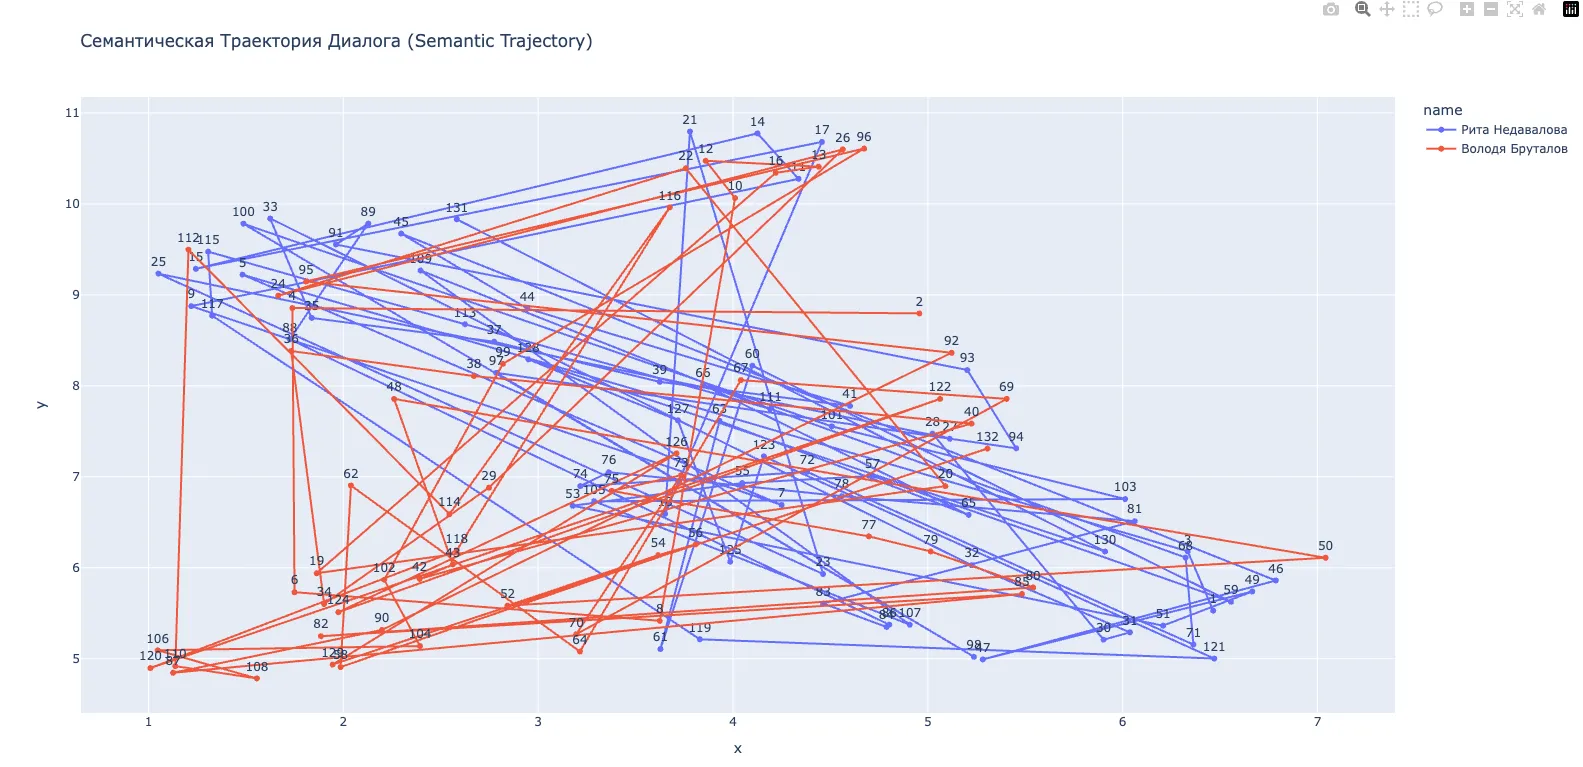
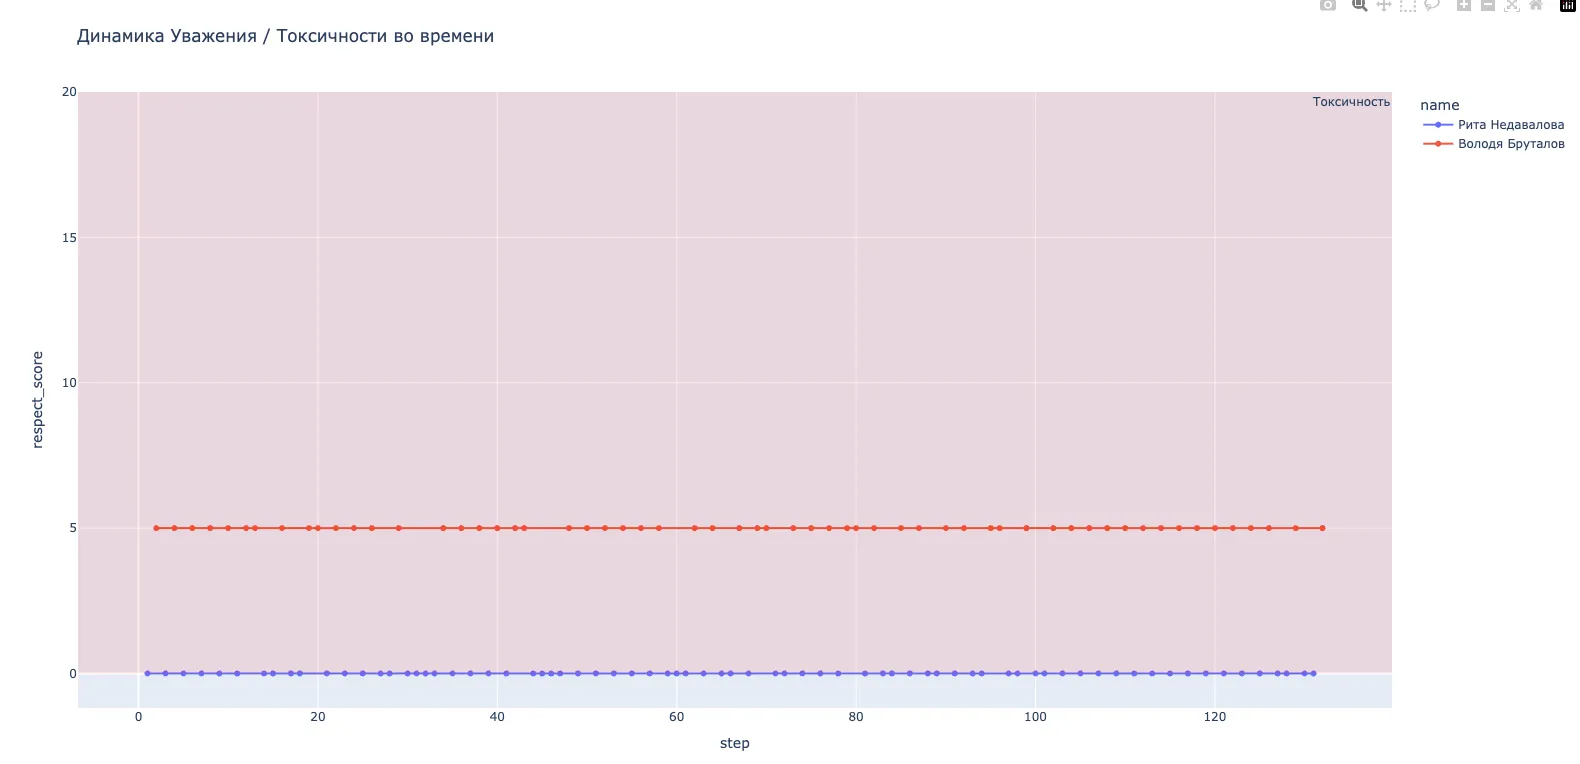
5. Взгляд в будущее: а могут ли такие MAS быть полезны бизнесу?
Смотря на то, как Рита и Володя ругаются, мне померещилось, что я собрал не просто fancy-генератор треш-стримов, а своеобразный прототип когнитивной архитектуры. В 2026 такая штука (при вдумчивом и целенаправленном развитии) может иметь потенциал в некоторых направлениях.
В B2B сегменте:
- ИИ-тренажеры для продаж и support’а: представим, что джун-продаван общается с таким вот “ИИ-Володей”, который отыгрывает максимально токсичного и трудного клиента. А третий агент-суфлер сидит “в ухе” джуна и анализирует
respect_scoreклиента в реальном времени, подсказывая, как закрыть сделку. Ну а если вообще раздухариться, то можно представить, что и джуна нет никакого, есть 3 агента: А - клиент с неким профилем из CRM’ки (а-ля: муж/ 30 лет/ офисный клерк… а еще, например, по Зодиаку - Козерог); Б - “ИИ-продаван”, который тренируется/обучается; В - ИИ-супервайзер, который в цикле обучения направляет агента Б. Короче, сказка, а не жизнь! - Автоматизированный brainstorming: в закрытом ИТ-контуре запускаются цифровые двойники Финдира (цель - резать косты) и верховного Маркетолога (цель - захват рынка любой ценой). Они спорят 100 итераций, а LLM-Судья выдает топ-3 инновационных решения, рожденных в этом конфликте. Вот и проверим, LLM - это “продвинутые цепи Маркова” или им уже права надо выдавать?
В B2C сегменте:
- Entertainment 2.0: Бесконечные ИИ-сериалы и стримы, где сюжет развивается органично, а зрители платят микротранзакции за возможность вкинуть новость в симуляцию и посмотреть, как агенты с ней справятся. Короче, кастомизация контента (пока только текстово-аудиального, но видосы скоро тоже подвезут) для любого из 8+ млрд homo на Земле.
- Companionship-приложения: Пользователь добавляет в чат двух агентов (например, “Рационалиста” и “Эмпата”), которые не просто отвечают юзеру, но и спорят между собой о том, как ему лучше помочь. Это может дать фантасмагоричный эффект живой компании. И вот, например, японцы в окна выходят от одиночества, а тут - живи со своими воображаемыми друзьями и нет проблем в палате №6.
Итог
Не знаю кто - как, но очевидно, что эпоха простых «вопрос-ответ» чат-ботов окончательно уходит. Будущее за мультиагентными системами, которые имеют скрытые мотивы, умеют рефлексировать и контролируются не человеком с красными глазами, а другими LLM-супервайзерами. И собрать такую систему сегодня может любой, кто освоил prompt engineering. “Разве ж это плохо, когда это просто збс!”
А вы бы посмотрели стрим, где ИИ-слесарь и ИИ-феминистка обсуждают “раздельный бюджет” или “скрепные скрепы”?